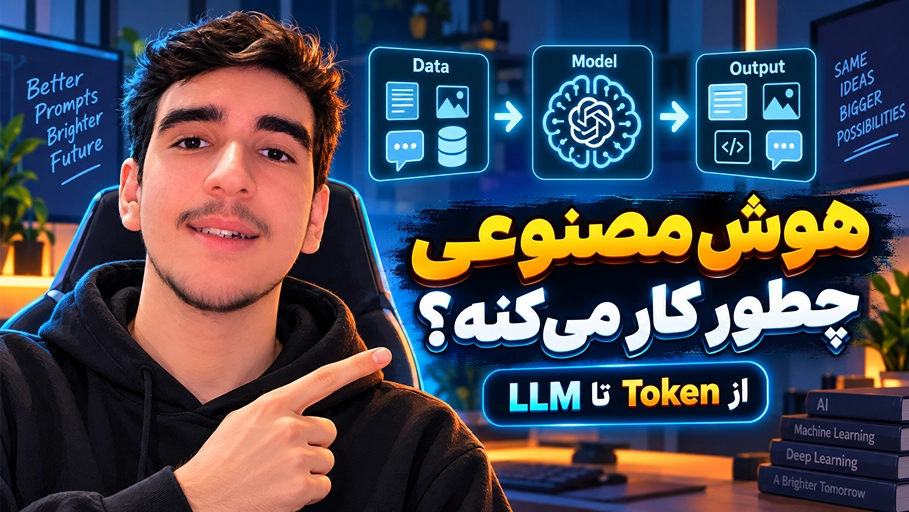
تماشای ویدیو مربوطه از طریق دکمه های زیر
تماشای قسمت اول
تماشای قسمت دوم
هوش مصنوعی چگونه کار میکند؟ از Token و LLM تا Dataset، RAG و RLHF
تقریباً همه ما امروز به شکلی از هوش مصنوعی استفاده میکنیم. از ChatGPT و Gemini گرفته تا ابزارهای تولید تصویر، کدنویسی، ترجمه، تولید ویدیو و حتی قابلیتهای هوشمندی که داخل گوشی و اپلیکیشنها قرار گرفتهاند.
اما سؤال مهم اینجاست:
هوش مصنوعی واقعاً چطور کار میکند؟
وقتی یک سؤال برای ChatGPT میفرستیم، آیا مدل واقعاً مثل یک انسان مفهوم سؤال را درک میکند؟ جوابها را از یک دیتابیس پیدا میکند؟ از اینترنت برمیدارد؟ یا اتفاق کاملاً متفاوتی پشت صحنه در جریان است؟
برای جواب دادن به این سؤال باید چند مفهوم مهم مثل Model، Training، Token، LLM، Transformer، Dataset، Benchmark، RAG و RLHF را بشناسیم.
اسم بعضی از این اصطلاحات شاید در نگاه اول پیچیده به نظر برسد، اما مفهوم بیشترشان بسیار سادهتر از چیزی است که تصور میکنید.
در این مقاله قرار است کل مسیر را از ابتدا تا انتها ببینیم؛ از لحظهای که داده جمعآوری میشود تا زمانی که شما یک Prompt میفرستید و مدل در چند ثانیه پاسختان را تولید میکند.
هوش مصنوعی دقیقاً چیست؟
هوش مصنوعی یا Artificial Intelligence یک اصطلاح کلی برای سیستمهایی است که میتوانند کارهایی را انجام دهند که معمولاً به نوعی هوشمندی نیاز دارند.
مثلاً:
- تشخیص تصویر
- ترجمه متن
- تشخیص صدا
- پیشنهاد فیلم و موسیقی
- تولید متن
- نوشتن کد
- تولید تصویر و ویدیو
- تحلیل اطلاعات
اما زیر مجموعه AI اصطلاح دیگری به نام Machine Learning یا یادگیری ماشین را داریم.
در برنامهنویسی سنتی معمولاً ما قوانین را مشخص میکنیم:
داده + قوانین → جواب
اما در Machine Learning به جای اینکه تمام قوانین را خودمان بنویسیم، تعداد زیادی مثال در اختیار سیستم قرار میدهیم تا خودش الگوها را پیدا کند.
مثلاً برای ساخت سیستم تشخیص Spam لازم نیست هزاران قانون دستی برای تشخیص ایمیل اسپم بنویسیم. میتوانیم تعداد زیادی ایمیل Spam و Normal به مدل نشان دهیم تا خودش الگوهای موجود را یاد بگیرد.
Model یا مدل چیست؟
یکی از مهمترین کلماتی که در دنیای AI میشنوید Model است.
مدل را میتوان نتیجه فرایند یادگیری در نظر گرفت.
یک مثال ساده:
- Data: کتابها و جزوههای دانشآموز
- Training: فرایند درس خواندن
- Model: چیزی که دانشآموز یاد گرفته
- Inference: زمانی که در امتحان از آموختههایش استفاده میکند
بنابراین یک مدل هوش مصنوعی صرفاً دیتابیسی نیست که میلیونها جواب آماده داخل آن ذخیره شده باشد.
مدل در فرایند آموزش، الگوهایی را از دادهها یاد میگیرد و بعد هنگام دریافت ورودی جدید از همان الگوها برای تولید خروجی استفاده میکند.
هوش مصنوعی از کجا یاد میگیرد؟ Dataset چیست؟
مدل نمیتواند از هوا چیزی یاد بگیرد.
برای آموزش به Data یا داده نیاز داریم.
به مجموعهای از دادههایی که برای آموزش یا ارزیابی مدل استفاده میشوند Dataset یا دیتاست گفته میشود.
فرض کنید میخواهیم مدلی بسازیم که بتواند گربه را از سگ تشخیص دهد.
ابتدا هزاران عکس جمع میکنیم:
- عکس گربه
- عکس سگ
- عکس گربه
- عکس سگ
- و الی آخر
این اطلاعات در ابتدا ممکن است Raw Data یا داده خام باشند.
داده خام معمولاً قبل از آموزش نیاز به آمادهسازی دارد. ممکن است تعدادی از تصاویر خراب، تکراری، بیکیفیت یا نامرتبط باشند.
بنابراین مسیر میتواند چیزی شبیه این باشد:
Raw Data → Clean Dataset → Training
یعنی ابتدا داده خام را جمع میکنیم، آن را تمیز و آماده میکنیم و سپس برای آموزش مدل مورد استفاده قرار میدهیم.
کیفیت Dataset اهمیت بسیار زیادی دارد. اگر دادههای آموزشی ناقص، اشتباه یا نامتعادل باشند، مدل نیز ممکن است الگوهای اشتباهی یاد بگیرد.
Label چیست؟
در بعضی دیتاستها کنار هر داده، جواب یا توضیحی هم قرار دارد که به آن Label یا برچسب میگوییم.
مثلاً:
image_01.jpg → Cat
image_02.jpg → Dog
image_03.jpg → Cat
در این مثال Cat و Dog همان Label هستند.
در مسئله تشخیص Spam هم میتوانیم داشته باشیم:
Email 1 → Spam
Email 2 → Normal
مدل با بررسی تعداد زیادی از این مثالها تلاش میکند رابطه بین ورودی و جواب صحیح را پیدا کند.
Training در هوش مصنوعی چیست؟
Training همان فرایند آموزش مدل است.
در یک نسخه بسیار سادهشده، مدل:
- یک ورودی دریافت میکند.
- یک پیشبینی انجام میدهد.
- پیشبینی آن با جواب صحیح مقایسه میشود.
- میزان خطا مشخص میشود.
- تنظیمات داخلی مدل کمی تغییر میکند.
- دوباره تلاش میکند.
این چرخه ممکن است تعداد بسیار زیادی بار تکرار شود.
مثلاً فرض کنید جواب صحیح یک مسئله عدد 100 است.
مدل در ابتدا میگوید:
Prediction: 63بعد از اصلاح میشود:
Prediction: 78و با ادامه آموزش:
Prediction: 91هدف این است که مدل به مرور الگوهای بهتری یاد بگیرد و خطای آن کمتر شود.
Parameter چیست؟
مدلهای یادگیری ماشین تعداد زیادی مقدار قابل تنظیم دارند که به آنها Parameter یا پارامتر گفته میشود.
در زمان Training این پارامترها تغییر میکنند.
برای درک ساده میتوانید تصور کنید داخل مدل تعداد بسیار زیادی «پیچ تنظیم» وجود دارد و فرایند آموزش دائماً این پیچها را مقدار کمی تغییر میدهد تا مدل بتواند پیشبینی بهتری انجام دهد.
وقتی میشنوید یک مدل میلیاردها Parameter دارد، منظور تعداد همین مقادیر یادگرفتنی داخل مدل است.
البته تعداد پارامترها به تنهایی مشخص نمیکند یک مدل چقدر خوب است.
Neural Network و Deep Learning چیست؟
بخش بزرگی از هوش مصنوعی مدرن بر اساس Neural Network یا شبکه عصبی ساخته شده است.
شبکه عصبی معمولاً شامل لایههایی است که اطلاعات از آنها عبور میکند:
Input → Hidden Layers → Output
مثلاً در تشخیص تصویر، لایههای مختلف میتوانند به مرور ویژگیهای پیچیدهتری از تصویر را پردازش کنند.
زمانی که شبکههای عصبی دارای تعداد زیادی لایه و ساختار پیچیدهتر باشند، وارد حوزهای میشویم که اصطلاحاً Deep Learning یا یادگیری عمیق نامیده میشود.
بسیاری از پیشرفتهای اخیر در پردازش:
- متن
- تصویر
- صدا
- ویدیو
با Deep Learning ارتباط دارند.
Generative AI چیست؟
همه مدلهای هوش مصنوعی فقط برای تشخیص دادن ساخته نشدهاند.
بعضی مدلها میتوانند محتوای جدید تولید کنند.
به این حوزه Generative AI یا هوش مصنوعی مولد میگوییم.
برای مثال:
تشخیص:
آیا این تصویر گربه است یا سگ؟
تولید:
یک تصویر از گربهای که پشت کامپیوتر نشسته بساز.
ChatGPT، Gemini، مدلهای تولید تصویر، مدلهای تولید موسیقی و سیستمهای تولید ویدیو نمونههایی از کاربردهای Generative AI هستند.
LLM چیست؟
LLM مخفف Large Language Model یا «مدل زبانی بزرگ» است.
سه قسمت این عبارت را جدا کنیم:
Large: مدل در مقیاس بزرگ
Language: برای پردازش و تولید زبان
Model: یک مدل یادگیری ماشین
ChatGPT خودش نام یک محصول است، اما مدلهایی که قابلیتهای زبانی آن را فراهم میکنند در خانواده مدلهای زبانی بزرگ قرار میگیرند.
Gemini و Claude نیز نمونههایی از محصولاتی هستند که مدلهای زبانی قدرتمند در پشت آنها قرار دارد.
Token چیست؟
مدل زبانی متن را دقیقاً به همان شکلی که ما میبینیم پردازش نمیکند.
متن ابتدا به واحدهای کوچکتری به نام Token یا توکن تقسیم میشود.
یک Token ممکن است:
- یک کلمه باشد
- بخشی از یک کلمه باشد
- یک علامت باشد
- یا قطعه کوچک دیگری از متن
بنابراین وقتی درباره تعداد Tokenهای یک Prompt یا قیمت به ازای Token صحبت میشود، منظور همین واحدهای پردازشی متن است.
مدل زبانی چطور جواب تولید میکند؟
حالا به یکی از مهمترین قسمتهای نحوه کار هوش مصنوعی میرسیم.
یک مدل زبانی در سطحی سادهشده تلاش میکند Token بعدی را پیشبینی کند.
فرض کنید ورودی این باشد:
پایتخت ایران ...
مدل برای ادامههای مختلف احتمال در نظر میگیرد:
تهران    بسیار محتمل
شیراز    احتمال کمتر
تبریز    احتمال کمتر
...
بعد یکی از گزینههای مناسب انتخاب میشود.
اما کار تمام نشده است.
مدل حالا با در نظر گرفتن متن قبلی دوباره Token بعدی را پیشبینی میکند.
و دوباره.
و دوباره.
به این شکل یک پاسخ کامل ساخته میشود.
پس پاسخ یکباره از داخل حافظه مدل بیرون کشیده نمیشود؛ خروجی بهصورت مرحلهبهمرحله تولید میشود.
Transformer چیست؟
یکی از مهمترین معماریهایی که پشت بسیاری از مدلهای زبانی مدرن قرار دارد Transformer نام دارد.
Transformer به مدل کمک میکند رابطه بین قسمتهای مختلف ورودی را بهتر پردازش کند.
یکی از اجزای معروف این معماری Attention است.
Attention یعنی چه؟
فرض کنید جملهای نسبتاً طولانی نوشتهایم.
برای فهم یک کلمه، همه کلمات دیگر به یک اندازه مهم نیستند.
Attention کمک میکند مدل بررسی کند برای پردازش قسمت فعلی، کدام بخشهای دیگر متن ارتباط بیشتری دارند.
البته Attention به معنی «توجه کردن آگاهانه مثل انسان» نیست؛ این یک سازوکار محاسباتی در معماری مدل است.
Context Window چیست؟
مدل هنگام پاسخ دادن به مجموعهای از اطلاعات دسترسی دارد که میتوان آن را Context یا زمینه فعلی در نظر گرفت.
برای مثال:
- دستورهای سیستم
- پیامهای قبلی گفتگو
- Prompt فعلی
- بخشی از فایلهایی که در اختیار مدل قرار گرفته
- اطلاعاتی که ابزارها برگرداندهاند
مقداری که مدل میتواند در یک تعامل پردازش کند به مفهوم Context Window مربوط میشود.
یک تشبیه ساده، میز کار است.
هرچقدر میز بزرگتر باشد، میتوانید مدارک بیشتری را همزمان جلوی خود قرار دهید.
Context Window را نباید با Training Data یا حافظه دائمی یکی دانست.
Hallucination چیست؟
احتمالاً برایتان پیش آمده که هوش مصنوعی با اعتمادبهنفس کامل، یک جواب اشتباه بدهد.
به چنین پدیدهای معمولاً Hallucination گفته میشود.
دلیل مهم آن این است که مدل زبانی اساساً برای تولید ادامه مناسب متن آموزش دیده است، نه اینکه هر جمله را بهصورت ذاتی و مستقل با واقعیت خارجی تطبیق دهد.
بنابراین:
روان بودن جواب ≠ درست بودن جواب
به همین دلیل در اطلاعات حساس، علمی، حقوقی، مالی یا اطلاعات روز بهتر است منابع پاسخ بررسی شوند.
Overfitting چیست؟
در جریان آموزش ممکن است مدلی روی دادههای Training عملکرد فوقالعادهای داشته باشد، اما وقتی داده جدیدی میبیند نتیجه ضعیفی ارائه دهد.
به این وضعیت Overfitting گفته میشود.
بهترین مثال، دانشآموزی است که نمونه سؤالها را کاملاً حفظ کرده اما مفهوم درس را نفهمیده است.
تا زمانی که همان سؤالها را بپرسید عالی جواب میدهد؛ اما سؤال کمی تغییر کند، دچار مشکل میشود.
Underfitting چیست؟
Underfitting تقریباً مشکل سمت مقابل است.
مدل آنقدر کم یا نامناسب یاد گرفته که حتی روی دادههای آموزشی نیز عملکرد مناسبی ندارد.
هدف اصلی این است که مدل به Generalization یا تعمیم مناسب برسد؛ یعنی چیزی یاد بگیرد که بتواند روی نمونههایی که قبلاً ندیده هم استفاده کند.
Loss Function و Gradient Descent چیست؟
برای بهتر شدن مدل اول باید بدانیم چقدر اشتباه کرده است.
اینجا مفهوم Loss Function وارد میشود.
Loss Function روشی برای اندازهگیری میزان خطای مدل است.
بعد باید پارامترها را طوری تغییر دهیم که Loss کمتر شود.
یکی از ایدههای مهم برای انجام این کار Gradient Descent است.
میتوانید آن را مثل پایین آمدن از یک کوه تصور کنید.
بالای کوه:
خطای زیاد
پایین دره:
خطای کمتر
مدل قدمبهقدم تنظیم میشود تا به نقطهای با Loss کمتر برسد.
به فرایند تنظیم مدل برای رسیدن به نتیجه بهتر نیز Optimization یا بهینهسازی گفته میشود.
Epoch و Batch چیست؟
Datasetهای واقعی ممکن است بسیار بزرگ باشند و معمولاً همه دادهها یکباره پردازش نمیشوند.
Batch یعنی یک بخش کوچکتر از دادههای آموزشی که در یک مرحله پردازش میشود.
Epoch نیز معمولاً به یک دور عبور مدل از کل مجموعه داده آموزشی گفته میشود.
ممکن است مدل در جریان Training چندین Epoch آموزش ببیند.
Training Data، Validation Data و Test Data
برای اینکه بفهمیم مدل واقعاً یاد گرفته یا فقط اطلاعات آموزشی را حفظ کرده، معمولاً دادهها را برای اهداف مختلف جدا میکنیم.
Training Data
دادهای که مدل مستقیماً با آن آموزش میبیند.
Validation Data
برای بررسی و تنظیم مدل در طول توسعه استفاده میشود.
Test Data
برای ارزیابی نهایی روی دادهای که مدل در Training از آن استفاده نکرده است.
نسبت دقیق این بخشها قانون ثابتی ندارد و بسته به پروژه متفاوت است.
Benchmark چیست؟
احتمالاً هنگام معرفی مدلهای جدید دیدهاید شرکتها نمودارهایی منتشر میکنند و میگویند مدلشان در Benchmark خاصی امتیاز بالاتری گرفته است.
Benchmark را میتوان مثل یک آزمون استاندارد برای مدلها در نظر گرفت.
مثلاً بررسی کنیم مدل در:
- ریاضی
- کدنویسی
- استدلال
- پاسخگویی
- درک زبان
چه عملکردی دارد.
اما یک نکته مهم وجود دارد:
امتیاز Benchmark بالاتر الزاماً به معنی بهتر بودن مدل برای نیاز شما نیست.
سرعت، قیمت، کیفیت خروجی واقعی، ابزارها، Context Window و نوع کاربرد نیز اهمیت دارند.
Data Contamination چیست؟
فرض کنید میخواهیم دو دانشآموز را با یک آزمون مقایسه کنیم، اما یکی از آنها از قبل دقیقاً سؤالهای امتحان را دیده است.
طبیعتاً مقایسه چندان منصفانه نیست.
در ارزیابی مدلها هم اگر بخشی از سؤالهای Benchmark در دادههای Training وجود داشته باشند، با مشکلی به نام Data Contamination روبهرو میشویم.
به همین دلیل طراحی ارزیابی معتبر برای مدلهای بسیار بزرگ کار سادهای نیست.
Bias در هوش مصنوعی چیست؟
مدلها از دادهها الگو میگیرند و دادههای دنیای واقعی همیشه کاملاً خنثی و متعادل نیستند.
اگر Dataset دارای سوگیری باشد، مدل نیز ممکن است بخشی از آن را یاد بگیرد.
به این مسئله Bias یا سوگیری گفته میشود.
مسیر ساده میتواند اینطور باشد:
Biased Data → Biased Model → Biased Output
برای همین کیفیت و تنوع داده آموزشی اهمیت زیادی دارد.
RLHF چیست؟
فقط قدرت مدل مهم نیست؛ رفتار آن نیز اهمیت دارد.
یکی از روشهایی که در توسعه برخی مدلهای زبانی برای Post-training و هماهنگتر کردن رفتار مدل استفاده شده RLHF است.
RLHF مخفف:
Reinforcement Learning from Human Feedback
یعنی استفاده از بازخورد انسانی در یک فرایند یادگیری تقویتی.
در یک توضیح ساده، انسانها میتوانند پاسخهای مختلف را ارزیابی یا مقایسه کنند و این اطلاعات برای هدایت بهتر رفتار مدل مورد استفاده قرار گیرد.
هدف این است که پاسخهای مدل صرفاً از نظر زبانی محتمل نباشند، بلکه بیشتر به سمت پاسخهای مفید و مورد انتظار حرکت کنند.
Alignment چیست؟
Alignment را میتوان تلاش برای هماهنگتر کردن رفتار سیستم هوش مصنوعی با اهداف و محدودیتهای موردنظر دانست.
مثلاً مدلی میخواهیم که:
- مفید باشد
- دستورها را بهتر دنبال کند
- رفتارهای خطرناک را کاهش دهد
- در شرایط مختلف قابلکنترلتر باشد
Alignment یک مرحله یا تکنیک واحد نیست؛ مجموعهای از روشها و طراحیها میتواند در آن نقش داشته باشد.
Prompting، RAG و Fine-tuning چه تفاوتی دارند؟
این سه اصطلاح خیلی با هم اشتباه گرفته میشوند.
Prompting
سادهترین روش، دادن دستور بهتر به مدل است.
مثلاً به جای:
درباره React بگو.
مینویسیم:
React را برای یک برنامهنویس مبتدی با یک مثال عملی توضیح بده و در پایان سه اشتباه رایج را هم بگو.
خود مدل را تغییر ندادهایم؛ فقط ورودی بهتری دادهایم.
RAG
RAG به سیستم اجازه میدهد قبل از تولید پاسخ، اطلاعات مرتبط را از یک منبع بیرونی پیدا کند و در اختیار مدل قرار دهد.
فرض کنید یک چتبات برای شرکت خودتان ساختهاید.
کاربر سؤال میپرسد:
شرایط مرجوع کردن محصول چیه؟
سیستم ابتدا داخل مستندات شرکت جستجو میکند، بخش مرتبط را پیدا میکند و سپس آن اطلاعات را برای مدل میفرستد تا بر اساس آن پاسخ دهد.
این یعنی بدون Training مجدد مدل، میتوانیم اطلاعات جدید یا اختصاصی در اختیار آن قرار دهیم.
Fine-tuning
در Fine-tuning خود مدل با دادههای تخصصی بیشتر تنظیم یا آموزش داده میشود.
این روش میتواند برای ایجاد رفتار، قالب خروجی یا تخصص خاص مفید باشد.
پس بهصورت خیلی خلاصه:
Prompting: دستور بهتر
RAG: اطلاعات بیرونی
Fine-tuning: تنظیم بیشتر خود مدل
Tool Calling چیست؟
مدلهای جدید لزوماً فقط متن تولید نمیکنند.
یک سیستم میتواند به مدل اجازه دهد از Tool یا ابزار استفاده کند.
مثلاً:
Prompt → Model → Tool → Result → Final Answer
ابزار میتواند:
- موتور جستجو
- اجرای کد
- دیتابیس
- تقویم
- ایمیل
- API
- سیستم داخلی یک شرکت
باشد.
همین قابلیت یکی از پایههای مهم ساخت سیستمهای Agentic است.
Agent هوش مصنوعی چیست؟
یک مدل ساده معمولاً چنین کاری میکند:
Prompt → Answer
اما یک Agent میتواند برای رسیدن به هدف چند مرحله انجام دهد:
Goal → Plan → Tool → Result → Next Step → Final Result
مثلاً اگر از یک مدل بپرسیم:
سه لپتاپ مناسب برنامهنویسی معرفی کن.
ممکن است صرفاً بر اساس اطلاعات موجود جواب بدهد.
اما یک Agent مجهز به ابزار میتواند:
- محصولات را جستجو کند.
- قیمت را بررسی کند.
- مشخصات را استخراج کند.
- آنها را مقایسه کند.
- نتیجه را مرتب کند.
Agent معمولاً ترکیبی از Model + Instructions + Tools + State/Memory است.
Quantization چیست؟
مدلهای بزرگ برای اجرا به منابع محاسباتی زیادی نیاز دارند.
Quantization یکی از روشهایی است که میتواند مصرف حافظه و هزینه محاسباتی مدل را کاهش دهد.
به شکل ساده، برخی محاسبات و وزنهای مدل با دقت عددی پایینتری نمایش داده میشوند.
نتیجه میتواند:
- مدل سبکتر
- مصرف حافظه کمتر
- اجرای سریعتر
باشد.
البته بسته به روش Quantization ممکن است مقداری افت کیفیت هم ایجاد شود.
Distillation چیست؟
در Knowledge Distillation معمولاً یک مدل قدرتمندتر نقش Teacher یا استاد را دارد و مدل کوچکتر نقش Student یا شاگرد.
هدف این است که مدل کوچکتر بخشی از رفتار یا دانش خروجی مدل بزرگ را یاد بگیرد.
به این ترتیب میتوان مدلی داشت که:
- کوچکتر باشد
- سریعتر اجرا شود
- هزینه کمتری داشته باشد
ولی همچنان عملکرد قابل قبولی ارائه دهد.
Mixture of Experts چیست؟
یکی دیگر از معماریهایی که در بعضی مدلها استفاده میشود Mixture of Experts یا MoE است.
ایده اصلی این است که برای هر ورودی لازم نیست تمام بخشهای مدل به یک اندازه فعال شوند.
یک بخش به نام Router تصمیم میگیرد کدام Expertها برای ورودی فعلی مناسبتر هستند.
به شکل ساده:
Input → Router → Selected Experts → Output
این معماری میتواند امکان داشتن ظرفیت زیاد مدل را بدون استفاده یکسان از تمام ظرفیت برای هر Token فراهم کند.
Multimodal AI چیست؟
مدلهای اولیه بیشتر روی یک نوع داده کار میکردند، اما مدلهای جدیدتر میتوانند چند نوع ورودی را پردازش کنند.
به چنین سیستمهایی Multimodal گفته میشود.
مثلاً یک مدل میتواند:
- متن بخواند
- تصویر را تحلیل کند
- صدا را پردازش کند
- ویدیو را بررسی کند
و سپس خروجی تولید کند.
وقتی یک تصویر برای یک مدل میفرستید و درباره آن سؤال میکنید، در حال استفاده از قابلیت Multimodal هستید.
پس هوش مصنوعی واقعاً چگونه کار میکند؟
اگر بخواهیم تمام این مقاله را در یک مسیر خلاصه کنیم، پشت بسیاری از سیستمهای AI چیزی شبیه این اتفاق میافتد:
Dataset
↓
Training
↓
Loss
↓
Optimization
↓
Trained Model
↓
Evaluation
↓
Alignment / Post-training
↓
Deployment
بعد زمانی که ما از مدل استفاده میکنیم:
Prompt
↓
Tokens
↓
Model
↓
Prediction
↓
Tools / External Data (در صورت نیاز)
↓
Output
بنابراین آن پاسخ چندخطی که ChatGPT، Gemini یا یک سیستم هوش مصنوعی دیگر در چند ثانیه به ما میدهد، نتیجه یک فرایند بسیار بزرگتر است.
قبل از رسیدن مدل به دست ما، حجم زیادی داده پردازش شده، مدل آموزش دیده، خطاهای آن کاهش پیدا کرده، عملکردش ارزیابی شده و سیستمهای مختلفی دور آن ساخته شدهاند.
جمعبندی
برای استفاده از هوش مصنوعی لازم نیست تمام ریاضیات پشت مدلهای عصبی را بلد باشید، اما شناختن مفاهیم اصلی باعث میشود خیلی بهتر متوجه شوید ابزارهایی که هر روز استفاده میکنید چه محدودیتها و قابلیتهایی دارند.
حالا وقتی کلماتی مثل LLM، Token، Transformer، Context Window، Dataset، Training، Benchmark، RLHF، RAG، Fine-tuning یا Agent را میشنوید، میتوانید هرکدام را در جای درست خودش قرار دهید.
هوش مصنوعی جادو نیست.
پشت خروجی مدلها ترکیبی از داده، الگوریتم، آموزش، بهینهسازی، ارزیابی و طراحی سیستم قرار دارد.
و دقیقاً وقتی این پشت صحنه را بشناسیم، میتوانیم به جای اینکه صرفاً کاربر ابزارهای AI باشیم، از آنها خیلی هوشمندانهتر استفاده کنیم.
نظرات (0)
ارسال نظر جدید
هنوز نظری ثبت نشده است. اولین نفر باشید!